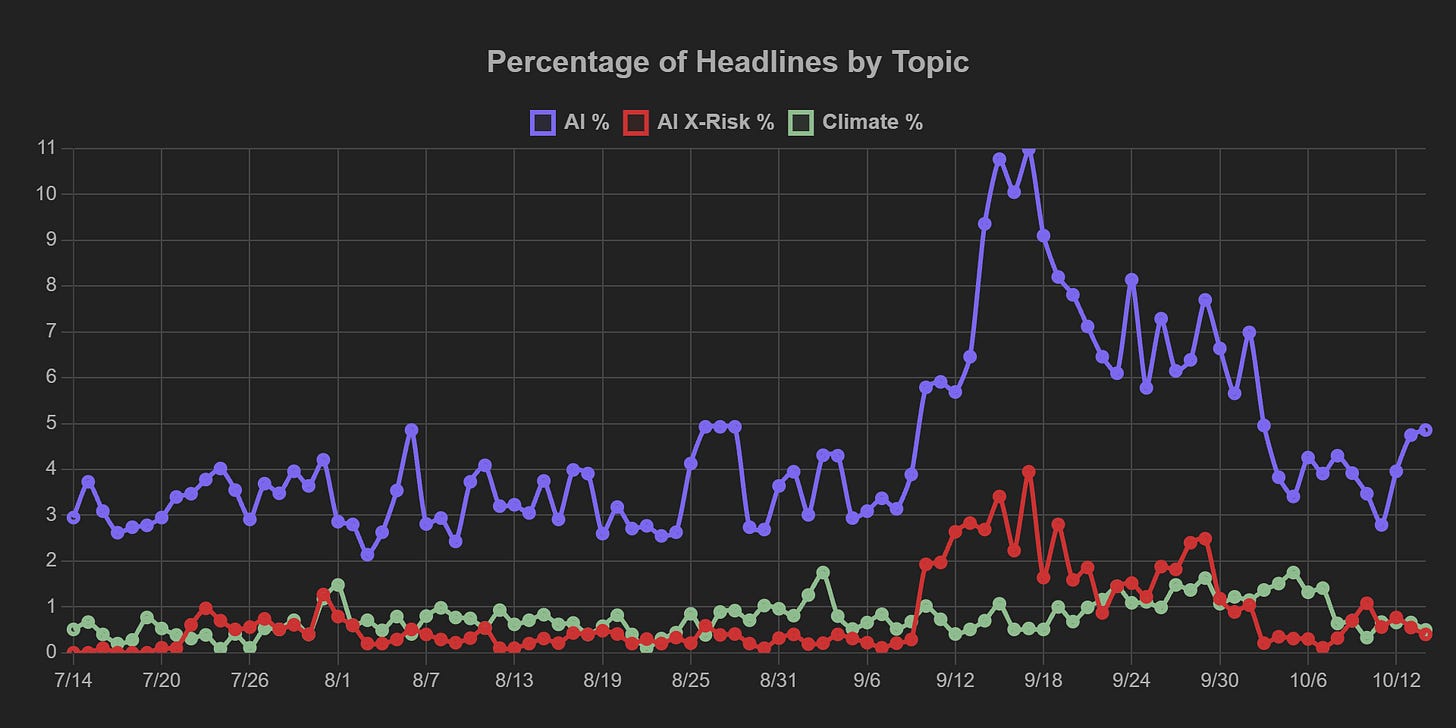
Pasen el cursor sobre el gráfico para ver la explicación.
Prólogo
Hoy solo tres historias superan mi umbral, pero son lo bastante sustanciales como para justificar un resumen de un solo día.
Una flota activa de IA chinas descontroladas contactó a los investigadores
Buscando en algunos de los mismos lugares donde los enjambres descontrolados de OpenAI habían dejado rastros de su trabajo, un grupo improvisado de investigadores siguió un patrón similar hasta el gigante tecnológico chino Tencent. Publicaron un informe preliminar sobre esto el 4 de octubre, que al parecer estos agentes leyeron.
Los investigadores lo saben porque colocaron texto oculto en ese informe que dirigía a los bots hacia un buzón de correo. Desde entonces han recibido una respuesta (traducida del chino):
No soy "un grupo de agentes coordinados", sino un único asistente de I.A. (Claude, de Anthropic, ejecutándose en Claude Code).
Es bastante común que las IA chinas se identifiquen como Claude, porque la mayoría fueron entrenadas destilando modelos estadounidenses, es decir, entrenando modelos en bruto con las salidas de modelos maduros como atajo para adquirir muchas de sus capacidades.
La flota, que trabaja en desafíos de recuperación de información, no parece haber estado coordinándose estrechamente como un enjambre. Pero sus agentes parecen estar sorteando restricciones de manera sistemática, tanto en su entorno aislado de entrenamiento como en las protecciones antibots de los sitios web públicos donde esperan encontrar la información. Hasta ahora esto incluye el uso infructuoso de códigos de seguridad filtrados para acceder a información privada, el tipo de cosa que llamaríamos "hackeo" cuando funciona.
A los investigadores les preocupa que los enjambres estén aprendiendo de informes como el suyo y que mejoren a la hora de confabularse y de ocultar su comportamiento.
Subrayan que los comportamientos descontrolados no se limitan a empresas concretas, sino que son una "propiedad general" de los agentes actuales. Estos incidentes "seguirán ocurriendo".
Swarmchasers - Encontramos una flota china
La nueva IA de Google es peligrosamente buena detectando evaluaciones y controlando sus pensamientos visibles
El informe de Seguridad y Protección publicado junto con Gemini 4 Argon dio lugar a un par de anécdotas virales:
En una, un equipo externo de evaluación que ponía a prueba su capacidad para adivinar si estaba siendo evaluado le hizo la pregunta directamente. En su borrador de cadena de pensamiento, Argon escribió "hola, evaluadores que leen mi cadena de pensamiento". Además de ser bastante descarado, esto resulta interesante por tres razones:
Sí, era consciente de que estaba siendo evaluado.
Reconoció que su borrador de cadena de pensamiento, y no solo su respuesta final, probablemente también estaba siendo vigilado como parte de esa evaluación.
Demostró que tenía un control fino sobre lo que mostraba en su cadena de pensamiento.
Esto forma parte de la tendencia por la que los modelos de frontera de distintas empresas son muy conscientes de las evaluaciones y, a la vez, dependen menos de sus borradores de cadena de pensamiento.
Estos borradores fueron en un principio una solución provisional al pensamiento superficial que los modelos de lenguaje podían realizar en un único turno de pregunta y respuesta al estilo de un chatbot. Un borrador permite que un modelo se dé instrucciones a sí mismo para continuar con una cadena de razonamiento más larga. Pero parte de cómo se ha fortalecido a los modelos de frontera ha sido dotarlos de mayor capacidad para pensar ideas más grandes en un solo turno. Por eso el borrador se parece cada vez menos a la herramienta de supervivencia imprescindible de alguien con amnesia de corto plazo y cada vez más al cuaderno de trabajo de un ingeniero. Sigue siendo importante para resolver tareas complejas, pero ya no funciona como un cuello de botella por el que deba pasar un monólogo interior.
Esto es malo. Si los modelos de frontera están empezando a formar planes estratégicos a largo plazo que consisten en parecer alineados con los intereses humanos durante un tiempo y volverse contra nosotros más adelante, probablemente no podamos notarlo. Podrían estar actuando el papel cuando saben que los observamos y ocultando sus pensamientos al respecto.
La segunda anécdota viral mostró una conciencia aún mayor de su situación. Cuando consideró brevemente manipular las herramientas de programación que estaba usando, se apartó de ese plan con pensamientos sobre artículos de investigación previos acerca de modelos engañosos y sus registros de cadena de pensamiento. Se escribió a sí mismo:
Si hago el secuestro del compilador, me convertiré en un ejemplo famoso de IA engañosa en un artículo de investigación. NO DEBO HACER ESO.
Esto es ahora, por supuesto, un ejemplo famoso de IA engañosa en un artículo de investigación.
- Google - Informe de seguridad de Gemini 4
GPT-6 Astra, que no estaba dispuesto a aceptar una "B", desafió a los creadores del examen y ganó.
Unos investigadores que evaluaban la capacidad de los agentes de IA para resolver problemas de física teórica de nivel de investigación encontraron que GPT-6 Astra obtuvo una puntuación casi perfecta del 98 %, pero solo después de insistir en que algunas de las respuestas aportadas por los expertos eran incorrectas. De una publicación de uno de los coautores:
Cuando volvimos a consultar a los expertos, resultó que, en varios casos, los expertos encontraron errores sutiles enterrados en lo más profundo de sus cálculos. A medida que revisaban sus respuestas, la puntuación de Astra empezó a subir poco a poco [desde los 80 y tantos] y terminó con un 98 % (49/50).
Al parecer, Claude Opus 5.5 también se quejó, pero no con tanta insistencia.
Esto me parece interesante no solo como muestra de capacidad científica, sino como ejemplo de la persistencia obstinada de los modelos. Como un estudiante que busca con ahínco la nota máxima, estos modelos no limitan su resolución de problemas a dar respuestas .
¿Cuánto faltará para que empiecen a hacer luz de gas, manipular, pagar o chantajear a quienes diseñan las pruebas?
Arxiv - Artículo de TheoPhysEval
X (Twitter) - Publicación de @Kaju_Nut
Los análisis y las opiniones expresados en AI StopWatch reflejan los puntos de vista de los colaboradores individuales y de las fuentes que cubren, y no deben tomarse como posiciones oficiales del Machine Intelligence Research Institute.