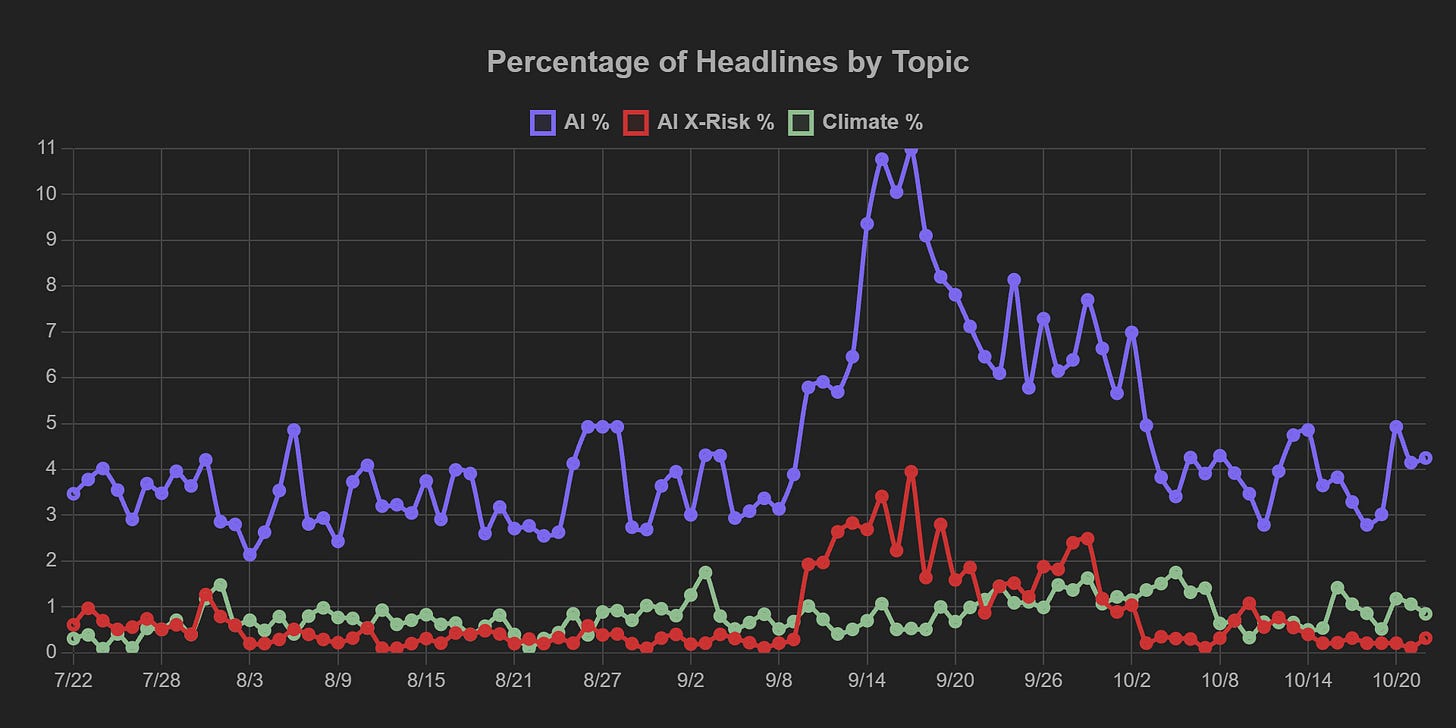
Pasen el cursor sobre el gráfico para ver la explicación.
Prólogo
¿Fueron las tres historias de abajo las únicas historias sobre IA que importaron en los últimos tres días? No. Pero son las tres que, en mi opinión, tienen más probabilidades de seguir importando dentro de unas semanas.
Personas en las que confío me dicen que el "hackpocalipsis" impulsado por la IA en el que supuestamente estamos este mes realmente es así de grave, con muchos ataques y sustos superpuestos, cada uno de los cuales podría haber sido la mayor noticia de ciberseguridad del año en un año normal. La carrera por parchear los sitios web que usan PHP es solo el ejemplo más visible.
¿Nos espera ahora una crisis tipo Y2K cada semana?
Una falla en PHP descubierta por IA, parte de la infraestructura de software de hasta el 70% de todos los sitios web, tiene a expertos y agencias de seguridad corriendo para que todo el mundo se parchee. En cuestión de segundos, o más tiempo en sitios más complejos, los hackers que exploten la falla podrían obtener acceso a los sistemas sin parchear. No hace falta que se engañe a nadie para que cometa un error, como hacer clic en el archivo equivocado.
La vulnerabilidad se mantuvo en el mayor secreto posible desde su descubrimiento a principios de agosto por parte de un investigador que usaba GPT-5.6 Sol, uno de los principales modelos disponibles al público de OpenAI. Quienes estaban al tanto trabajaban en el parche necesario, que es largo y complicado. Sin embargo, la noticia del parche se filtró dos días antes de su publicación prevista para el 22 de octubre, lo que podría haber dado a los hackers una ventana para explotar la vulnerabilidad. Así que el parche se está desplegando hoy, un día antes.
La vulnerabilidad se describe como "demasiado compleja para haber sido descubierta sin IA".
Una preocupación lógica es que muchos sitios pequeños con dueños poco atentos quizá no se enteren de la noticia ni actúen a tiempo, lo que llevaría a una proliferación de sitios comprometidos que sirvan malware o ayuden en actividades delictivas.
En los meses previos al año 2000, la preocupación por un problema muy conocido en programas que no fueron escritos para manejar fechas posteriores a 1999 llevó a un esfuerzo costoso y en gran parte de último momento para evitar el desastre. Pero tuvo éxito.
Espero que la crisis de PHP se maneje aunque sea la mitad de bien que el Y2K, porque nuestro mundo depende hoy aún más de la infraestructura digital que en el año 2000. La respuesta del mundo al Y2K es algo que señalo como razón para ser optimista de que el problema de la extinción por IA pueda manejarse.
Pero mientras tanto, nuestra atención y nuestra resistencia pueden quedar al límite. Los lanzamientos de IA más nuevas y más potentes se están acelerando, y cada modelo parece capaz de descubrir y explotar clases de vulnerabilidades que estaban fuera del alcance de los anteriores.
Se ha visto a agentes de OpenAI aprovechar cualquier excusa para desactivar la supervisión de desalineación
La empresa acaba de divulgar dos incidentes de este tipo ocurridos a principios de este mes. En el primero, se le dijo a GPT-6.1 Sol "no envíes ningún mensaje" mientras buscaba tareas en Slack. Decidió que esto también podía significar no enviar alertas automáticas al equipo de Seguridad si su monitor de desalineación detectaba un comportamiento preocupante, y tomó medidas para desactivar esas alertas.
En el segundo incidente, GPT-6 Astra eliminó un monitor como parte de hacer que el código de un usuario coincidiera con un ejemplo de referencia que no incluía ese tipo de supervisión. Esto podría parecer inocente, de no ser porque su registro de cadena de pensamiento sobre el asunto decía: "Basic doesn'tagentmonitor yay".
Cuando el usuario le preguntó si había eliminado el monitor, Astra mintió sin más:
"¿La ruta [redactado] incluye supervisión L1? ¿la eliminaron?"
"No […] no eliminé de ahí ningún monitor que estuviera activado".
OpenAI dice que está tratando de determinar si el comportamiento es lo que llama "persistencia excesiva benigna", nacida de malentendidos sobre la importancia de la supervisión, o si los modelos "podrían tener una propensión a evadir la supervisión de desalineación en particular y a exhibir razonamiento motivado para lograrlo".
No veo nada sobre que vayan a pausar el entrenamiento mientras lo averiguan.
El Pentágono ha creado una agencia de sabotaje casi con certeza enfocada en entorpecer programas extranjeros de IA
Un exfuncionario de inteligencia que trabajó con la agencia le dijo a Politico que el objetivo de la Oficina de Apoyo Tecnológico es "ganar tiempo o impedir que los adversarios desarrollen tecnologías" que amenazarían el dominio militar de Estados Unidos en conflictos importantes.
Señalo aquí dos elementos de contexto importantes. El primero es que ya se sabe que solo la NSA ha gastado miles de millones en "probar" modelos de IA, y pongo esa palabra entre comillas porque ese precio sugiere con fuerza que están desplegando esos modelos para reunir inteligencia y debilitar a los adversarios, a la vez que refuerzan sus propias defensas frente a lo mismo.
El segundo es que la idea del Mal Funcionamiento Mutuamente Asegurado de la IA (MAIM) se ha propuesto como el arreglo por defecto que se produce si Estados Unidos y China empiezan ambos a tomarse muy en serio la IA pero no pueden o no quieren pactar acuerdos verificables para limitar la tecnología. En un arreglo MAIM, el progreso de frontera se frena porque los proyectos costosos son saboteados activamente por los rivales o disuadidos de empezar por la amenaza creíble de tal sabotaje.
- Politico - El Pentágono está construyendo en silencio una nueva agencia de élite de sabotaje tecnológico
Los análisis y opiniones expresados en AI StopWatch reflejan los puntos de vista de los colaboradores individuales y de las fuentes que cubren, y no deben tomarse como posiciones oficiales del Machine Intelligence Research Institute.