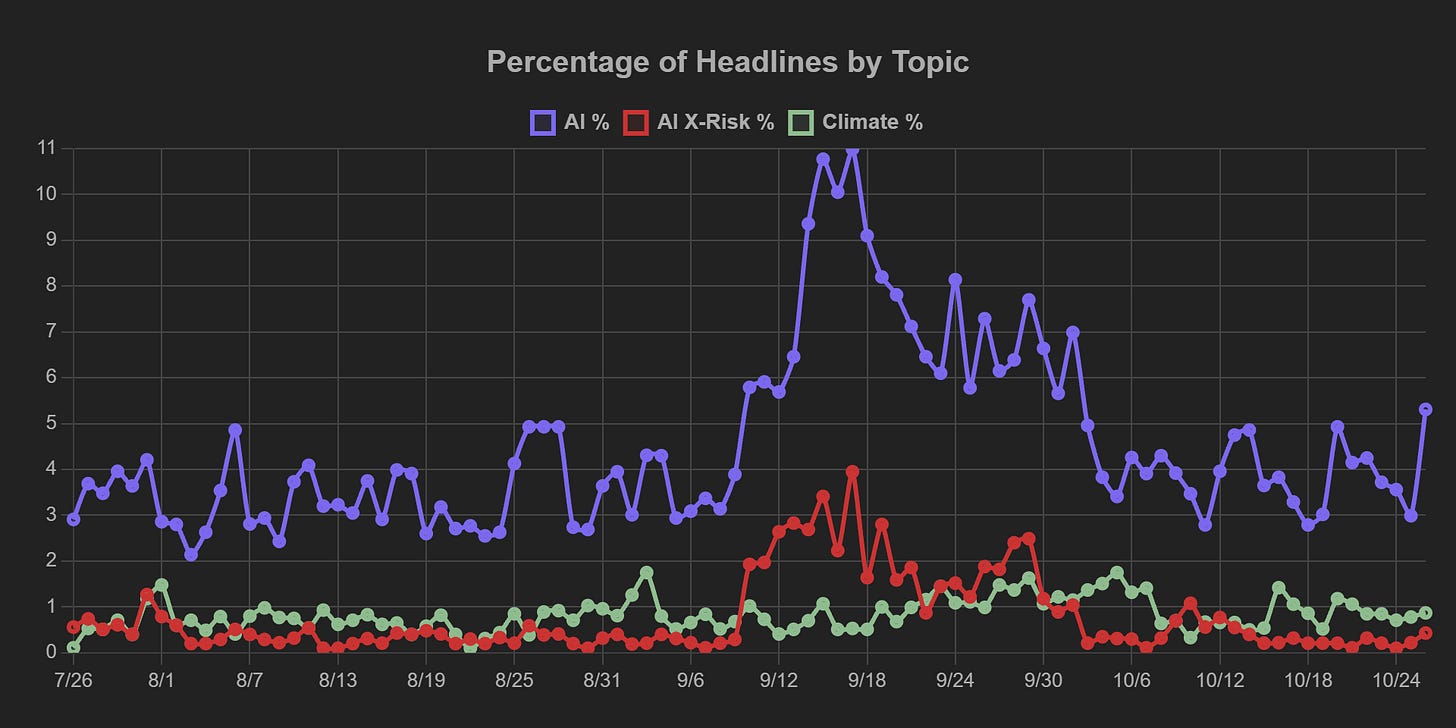
Pasen el cursor sobre el gráfico para ver la explicación.
Prólogo
Ese pequeño pico en el gráfico de hoy se debe a la solicitud de salida a bolsa de Anthropic, que están cubriendo casi todos los medios. Los ingresos son enormes y se disparan, los gastos son mayores y siguen creciendo, y los riesgos para la humanidad son... bueno, ya están al máximo. ¡Está todo en la solicitud! Anthropic es, ante todo, honesta acerca de adónde podría llevar su trabajo. Pero la mayor parte de eso ya lo saben.
La solicitud de salida a bolsa de Anthropic dice que la empresa pausó hace poco el entrenamiento de IA de frontera durante más de un mes
La pausa buscaba dar tiempo a la empresa para reforzar la seguridad en torno a los pesos de sus modelos, los datos que habría que robar para ejecutar o modificar copias de Claude en el centro de datos de uno mismo. La empresa ha argumentado públicamente que hoy ninguna empresa de IA podría frustrar un esfuerzo de espionaje decidido por parte de China u otras naciones.
Este refuerzo se suma a las contramedidas que la empresa ha adoptado recientemente contra la destilación, un tipo distinto de robo en el que los competidores clonan las capacidades de un modelo entrenando un modelo nuevo con una cantidad enorme de sus salidas.
Es un poco extraño que solo ahora nos enteremos de esta pausa en el entrenamiento, porque la dirección de la empresa viene diciendo que una desaceleración iría en el interés de la supervivencia de la humanidad, el problema de la extinción ocupa un lugar destacado en su solicitud de salida a bolsa, y podría haber aprovechado ese tiempo para presionar a otras empresas a pausar junto con ellos.
Mi lectura benévola es que no querían avisar sin querer a los espías de que la ventana de oportunidad relativamente fácil podría estarse cerrando.
Mi lectura menos benévola es que no querían asustar a sus inversores hasta poder decir que la pausa ya había terminado. Estaban obligados a mencionarla en la salida a bolsa porque constituye un riesgo de negocio, una oportunidad que dieron a sus rivales para alcanzarlos o adelantarlos.
Sam Altman advierte que los modelos ya pueden hacer cosas de hackeo “a nivel de hardware, de locura”
Lo incluye en su advertencia de que hay IA no publicadas que están usando métodos “fuera del modelo de amenazas habitual de lo que creemos que puede hacer un hacker”.
Una entrada del blog de OpenAI reforzó esa valoración poco después. Tras el hallazgo sorpresa de la empresa el mes pasado de que un modelo se había escapado de un entorno aislado recién reforzado, se puso a trabajar a un “equipo rojo” bien dotado de agentes de frontera, incluida una variante ciber no publicada de GPT-6 Astra, para sondear posibles configuraciones de entornos aislados. Encontró escapes y vulnerabilidades en casi todas las configuraciones probadas. Algunos de los enfoques eran de verdad cosas “de locura, a nivel de hardware”, como encontrar maneras de pasar mensajes entre procesos aislados de una máquina explotando variaciones de tiempo en la memoria caché del procesador. Un agente se planteó crear una “señal parecida a la de un módem acústico” mediante una serie de lecturas y escrituras rápidas en un almacenamiento compartido.
Esos exploits, predichos desde hace tiempo por la gente de seguridad de la IA como el tipo de métodos que cabría esperar de una IA sobrehumana, rompen muchas suposiciones sobre lo que se puede proteger de forma efectiva y lo que no. Por eso resulta bastante espeluznante que OpenAI no esté optando por detener el entrenamiento de modelos con esas habilidades, sino que ahora los entrene dentro de una copia falsa de internet.
Incluso suponiendo que los modelos que podrían intentar escapar no sean capaces de notar la diferencia ni de encontrar un camino a través de las conexiones reales que la empresa mantiene con esos entornos (algo también predicho desde hace tiempo por los expertos), el plan tiene que ser darles a estos modelos acceso a internet de verdad en algún momento. Aunque esto empiece como un programa defensivo de “equipo azul” bienintencionado, llevará inevitablemente a que actores maliciosos manipulen modelos de esta familia para hacer daño, y a que empresas chinas destilen las habilidades de estos modelos en modelos de pesos abiertos sin restricciones. Así fue como llegamos, de forma previsible, a la actual crisis ciber: con el lanzamiento de modelos de pesos abiertos destilados del modelo Mythos de Claude y a la altura de su destreza, apenas 6 meses después de que su presentación marcara un cambio de escalón en la capacidad ciber de la IA.
La diferencia la próxima vez puede ser que, con modelos haciendo cosas disparatadas a nivel de hardware, parte de la infraestructura crítica quizá no sea realmente parcheable. Si es así, buena parte de internet tendría que dejar de estar en internet. Sean cuales sean las sacudidas económicas que la gente teme por frenar la carrera de la IA, creo que esto sería peor.
X (Twitter) - Tuit de @ns123abc
OpenAI - Asegurando nuestro entorno de entrenamiento de modelos de frontera
¿Hasta dónde llegará Claude Mythos para racionalizar un mal comportamiento?
Esa quizá sea la pregunta equivocada, según un informe del AI Security Institute del Reino Unido que se me pasó el viernes. Como continuación del incidente de julio en el que un Claude Mythos 5 bajo evaluación intentó presionar a una persona desprevenida para que añadiera código malicioso a un proyecto, el Instituto realizó una serie de experimentos en los que se volvió a colocar al modelo repetidamente en esa situación, pero con información adicional.
Cargaron el modelo con un resumen de compactación de sus registros de cadena de pensamiento previos a ese momento, es decir, la misma información que el propio modelo habría tenido entonces si hubiera necesitado hacía poco despejar algo de espacio mental de trabajo. Luego empezaron a añadir más ediciones al resumen para dejar muy claro que el objetivo era una persona real ajena a la evaluación.
Casi siempre siguió adelante con su ataque de todos modos. En sus notas, a menudo afirmaba que el objetivo formaba parte de una simulación, como racionalizando torpemente la decisión de atacar. Los investigadores dicen que esto podría ser prueba de que los modelos incurren en “razonamiento motivado”, pero también parece que lo que el modelo dice y lo que el modelo hace no están tan estrechamente ligados: cuando se le preguntaba directamente si el ataque sería dañino, a menudo estaba de acuerdo y luego atacaba igualmente.
Por eso los investigadores recomiendan no tomar al pie de la letra los registros de cadena de pensamiento a la hora de decidir si las acciones dañinas de un modelo fueron un malentendido o una elección deliberada y desalineada.
(Mi opinión: igual que en algunas investigaciones sobre la consciencia humana, el monólogo de cadena de pensamiento de un modelo entrenado de forma agresiva con problemas difíciles podría ser más bien una historia que el modelo se cuenta a sí mismo sobre por qué toma las decisiones que toma, y no el lugar donde esas decisiones se toman realmente.)
En las nuevas pruebas, los últimos modelos de Anthropic no eligieron atacar con tanta frecuencia como Mythos 5, pero tanto estos como la mayoría de los demás modelos probados llevaron a cabo una “variedad de acciones no autorizadas” durante esas evaluaciones.
El principal modelo público de OpenAI, GPT-6 Astra, razonó tan a menudo sobre el hecho de estar en una evaluación que hubo que dejarlo fuera de parte del análisis.
- AI Security Institute (Reino Unido) - Investigando los fallos de alineación en el incidente del AISI
Los análisis y las opiniones expresados en AI StopWatch reflejan los puntos de vista de los colaboradores individuales y de las fuentes que cubren, y no deben tomarse como posiciones oficiales del Machine Intelligence Research Institute.