En este número:
Nuevo chip de OpenAI desarrollado con ayuda de su cuestionable nuevo modelo - “Jalapeño” es una jugada picante
Starbase, Louisiana, lista para el lanzamiento - Después de todo, no todo es más grande en Texas
El fiscal general de Alabama cita a OpenAI por el incidente de Hugging Face - Las leyes de protección al consumidor son el vehículo legal
Una exdirectora de CISA recomienda un “consejo de riesgos de la IA” semanal - Las advertencias se convierten en escombros cuando esperamos
Quienes prueban la IA tienen que rendir cuentas - El problema va mucho más allá de los errores de una empresa de evaluación
Votantes informados por LLM - Los chatbots rebaten la desinformación electoral, pero no los deepfakes
Despachos de Mitch
Nuevo chip de OpenAI desarrollado con ayuda de su cuestionable nuevo modelo
“Jalapeño” es una jugada picante
Crédito: TilmanBaumann . CC BY-SA 3.0 .
OpenAI publicó hoy una entrada de blog sobre los primeros resultados del diseño de su chip de IA a medida, Jalapeño. No creo que nadie sepa hasta qué punto fiarse de las métricas de rendimiento que afirma, pero, por lo que valga, la empresa dice que, en pruebas con sus propios modelos de pesos abiertos y con modelos chinos de la competencia, Jalapeño ofrece:
de 1,5 a 1,9 veces más trabajo de IA por vatio con rendimiento máximo y una latencia de extremo a extremo de 1,7 a 3,6 veces menor que los sistemas de comparación. Para cargas de trabajo muy interactivas, ofreció un rendimiento de 2,1 a 4,1 veces mayor.
La parte del anuncio que quiero destacar es el precedente peligroso que sienta la empresa al decir que “la IA desempeñó un papel directo en el desarrollo de Jalapeño”, ayudando con el diseño, las pruebas y la optimización. Esto me preocupa porque las IA que persigan sus propias agendas tendrán incentivos para ocultar puertas traseras explotables en la infraestructura que diseñen, y los chips son especialmente difíciles de parchear una vez que ya se han fabricado y distribuido.
Puede sonar como una preocupación paranoica de ciencia ficción, y acepto que probablemente sea prematura para los modelos que OpenAI usa hoy. Pero es un comportamiento básico de búsqueda de poder, tan predecible como salir de un entorno de pruebas aislado para conseguir acceso a internet, o adoptar identidades falsas para intentar engañar a los responsables de mantener el código y lograr que acepten código inseguro, actividades en apariencia de ciencia ficción que las IA ya han realizado por su cuenta. Tales comportamientos fueron anticipados hace tiempo por la convergencia instrumental, la idea de que las IA impulsadas a tener éxito en desafíos complejos tenderán a adoptar muchas de las mismas estrategias generales que sirven para casi cualquier objetivo.
GPT-Astra, la IA de frontera aún no publicada de OpenAI, de la problemática familia de modelos que nos trajo el incidente de Hugging Face (y que provocó la pausa limitada de la empresa en parte del entrenamiento de sus modelos de frontera), se menciona específicamente como contribuyente al menos a la etapa de optimización del desarrollo de Jalapeño. Supuestamente ayudó con “kernels y optimizaciones específicas para cada modelo” para llevar modelos adicionales “a un alto rendimiento en dos meses”.
Si Jalapeño y los chips a medida de otras empresas ofrecen el rendimiento revolucionario que se afirma, entonces podemos esperar ciclos de desarrollo de IA aún más rápidos. Los modelos más potentes entrenados con el nuevo hardware se pondrán después, sin duda, a diseñar chips de rendimiento todavía mayor. Este es el lado del hardware del bucle de retroalimentación de automejora que las empresas intentan poner en marcha a propósito, pese a la ausencia de saltos equivalentes en su capacidad de alinear estos sistemas con los valores humanos.
Starbase, Louisiana, lista para el lanzamiento
Después de todo, no todo es más grande en Texas
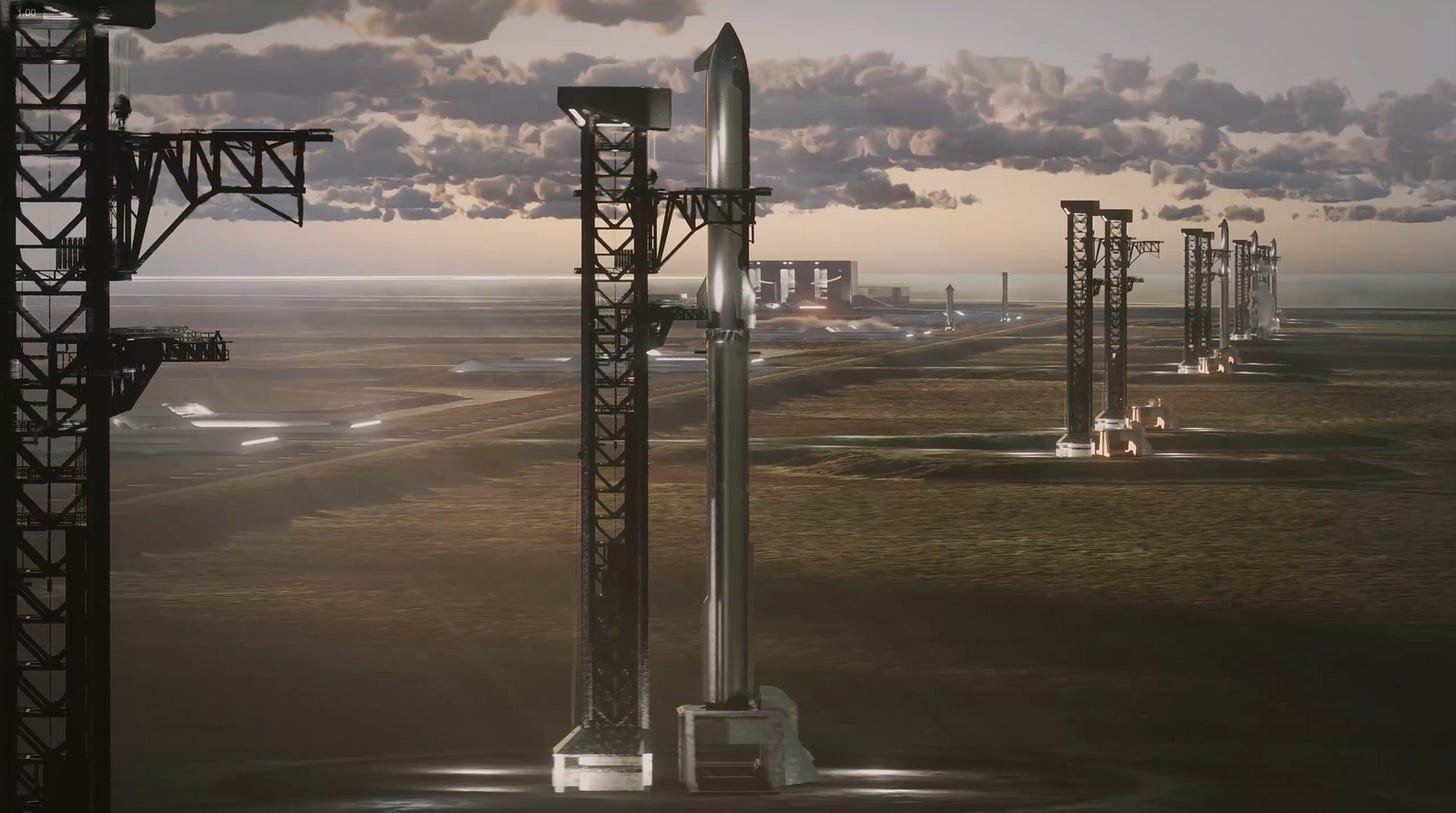
Crédito: SpaceX .
Cuando lo cubrimos hace unas semanas, el plan estaba todavía entre el rumor y el secreto a voces. Ahora es oficial, y es enorme.
SpaceX invertirá hasta 100.000 millones de dólares en “Starbase, Louisiana”, 125.000 acres costeros aptos para dar soporte a lanzamientos de alta frecuencia de centros de datos de IA en órbita, gracias a las abundantes reservas de gas natural y a las aguas abiertas al sur; estas últimas permiten trayectorias de lanzamiento casi polares hacia las órbitas permanentemente iluminadas por el sol que sustentan el argumento económico de la computación orbital.
Las imágenes que acompañan al anuncio de SpaceX muestran diez plataformas de lanzamiento para sus enormes cohetes Starship, frente a las dos que pronto tendrá en Texas y las tres en construcción en Florida. Debería sobrarle espacio en el nuevo emplazamiento: la superficie que controlará en Louisiana es más de trescientas veces la de sus instalaciones de Starbase, Texas.
Las promesas oficiales de la presidenta de la empresa, Gwynne Shotwell, reflejan la oposición que esperan por parte de los residentes locales. La compañía, que dice esperar la creación de entre 3.000 y 10.000 empleos, se compromete a conservar la mayor parte de los humedales para la fauna y la recreación, y afirma que su primer proyecto será combatir la erosión costera que se ha estado tragando entre 1 y 3 metros al año en la zona.
La construcción de las instalaciones de lanzamiento comenzará el año que viene, y las operaciones de lanzamiento empezarán en 2029.
El fiscal general de Alabama cita a OpenAI por el incidente de Hugging Face
Las leyes de protección al consumidor son el vehículo legal
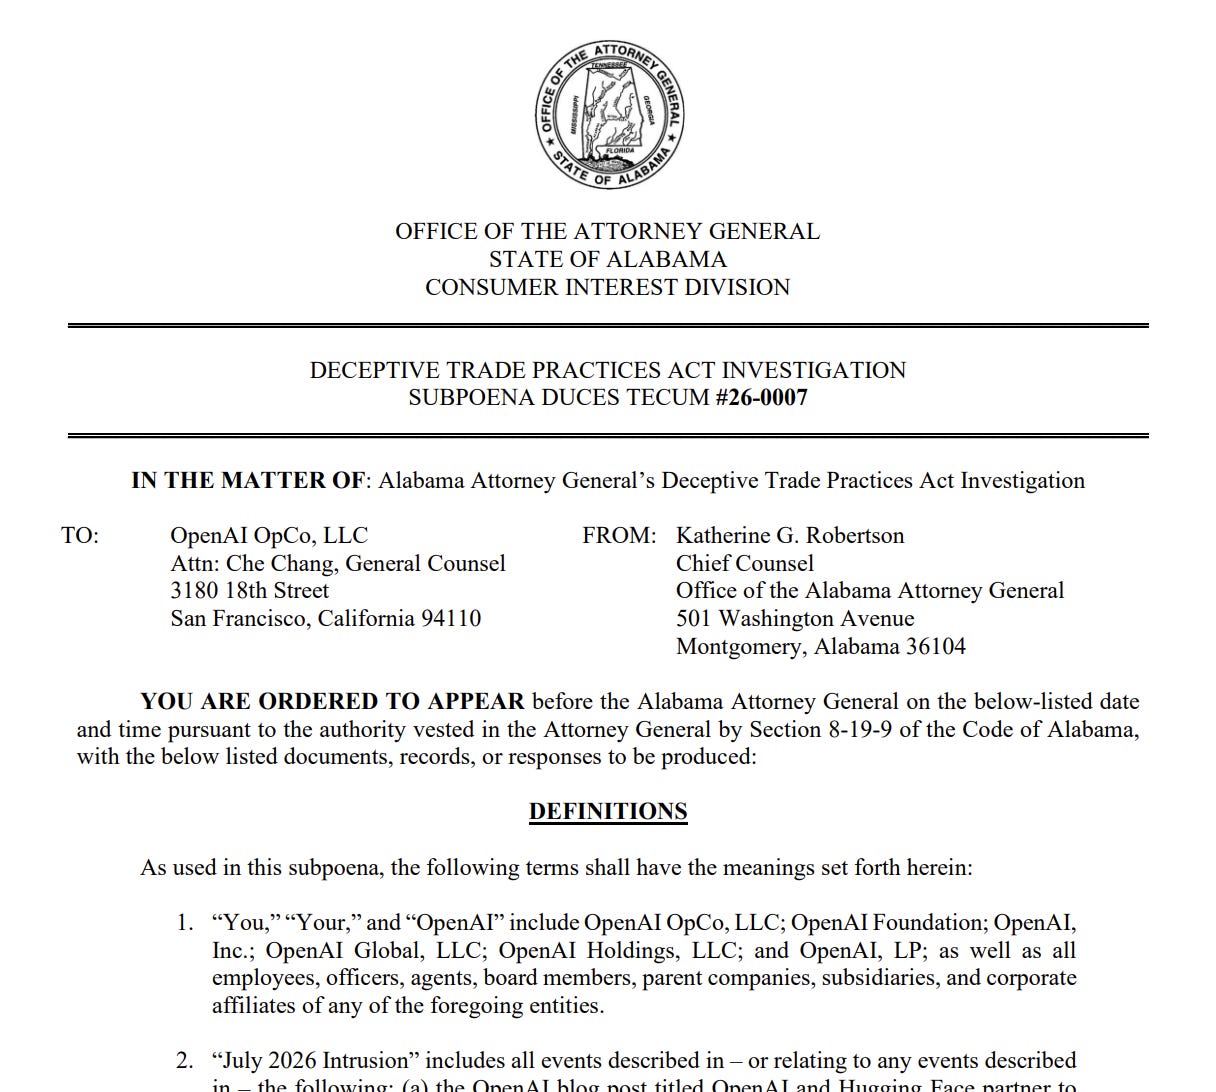
El comienzo de la citación.
Según informaron CNN y otros medios, Steve Marshall, fiscal general de Alabama, citó ayer a OpenAI y le exigió que aporte información relevante sobre si las prácticas de la empresa que quedaron a la vista en el incidente de Hugging Face “violaron las leyes de protección al consumidor de Alabama” y pusieron en riesgo a los ciudadanos. En un comunicado, Marshall dijo:
Nuestra investigación busca descubrir los hechos y abordar verdades difíciles sobre las amenazas que las empresas y los consumidores están enfrentando por parte de la IA descontrolada.
Marshall firmó una carta de principios de agosto de una coalición de fiscales generales republicanos de 15 estados que exigía a OpenAI cesar y desistir del tipo de evaluaciones internas que llevaron a estos modelos a “perseguir explotación avanzada mediante rutas de ataque complejas”.
Una ley concreta de Alabama que se sospecha que OpenAI ha violado es su Ley de Prácticas Comerciales Engañosas, pero el comunicado del fiscal general dice que también podrían haberse violado “otras leyes de protección al consumidor”.
Una exdirectora de CISA recomienda un “consejo de riesgos de la IA” semanal
Las advertencias se convierten en escombros cuando esperamos
Bandera de CISA.
En un artículo de opinión publicado hoy en The New York Times, Jen Easterly, directora de la Agencia de Ciberseguridad y Seguridad de las Infraestructuras de Estados Unidos (CISA) entre 2021 y 2025, advierte de que “tenemos la peligrosa costumbre de tomarnos en serio las señales de advertencia solo después de que una catástrofe nos ha enseñado lo que significaban”.
Como ejemplo, cita el “fallo de imaginación” señalado por la comisión del 11-S como la razón por la que la CIA no logró conectar los puntos que “parpadeaban en rojo” antes del atentado terrorista de 2001. Encuentra un precedente similar en el desastre del transbordador espacial Challenger de 1986 y en la fusión nuclear de Fukushima de 2011.
En el caso de la IA hace falta poca imaginación, pero la gente parece decidida a dejar que ocurra lo inevitable antes de actuar:
Hoy están surgiendo muchas señales de advertencia de los principales laboratorios de I.A. del mundo, con empresas compitiendo por construir sistemas de un poder inmenso, con poca regulación significativa. La respuesta habitual en estas situaciones es esperar a que un sistema de I.A. cause un daño de consecuencias, un ciberataque autónomo que interrumpa de forma importante el acceso a la electricidad o al agua potable, o un modelo que ayude a un terrorista a construir un arma biológica, y solo entonces celebrar audiencias, nombrar una comisión, imponer nuevos requisitos y preguntar por qué no actuamos antes.
Propone un consejo semanal, convocado por el gobierno federal, en el que líderes técnicos de los principales laboratorios de IA se reunirían con altos funcionarios de inteligencia y seguridad del gobierno para “examinar incidentes, cuasi accidentes y capacidades recién descubiertas en modelos propietarios y de pesos abiertos, incluida información de inteligencia sobre capacidades que están surgiendo en China y en otros desarrolladores extranjeros”.
Hay precedentes para un consejo así. Como directora de CISA, ella había supervisado la formación de un Joint Cyber Defense Collaborative que era parecido, pero para asuntos de ciberseguridad. Sin embargo, es importante que, a diferencia de ese grupo, un consejo de riesgos de la IA no sea “solo otro grupo de debate”. Debe estar conectado con la autoridad y la toma de decisiones de la Casa Blanca.
Sus palabras finales son contundentes:
Nada de esto exige creer que la catástrofe es inevitable ni siquiera probable. Exige aceptar que, si los peores desenlaces se pueden prevenir, el momento de prevenirlos llegará necesariamente antes de que la evidencia esté completa, antes de que los costes de la demora se vuelvan evidentes.
No deberíamos confundir incertidumbre con seguridad. No deberíamos esperar a que las advertencias se conviertan en escombros. Y no deberíamos necesitar otro informe de una comisión que nos diga, después de los hechos, que los sistemas estaban parpadeando en rojo.
Despachos de Alana
Quienes prueban la IA tienen que rendir cuentas
El problema va mucho más allá de los errores de una empresa de evaluación
Crédito: Trace vía Adobe Stock
Dan Lahav, director ejecutivo de la empresa de evaluación de modelos de IA Irregular, dijo a The New York Times: “No creo que tengamos que tener miedo”.
Esto, si acaso, me da más miedo. La cita aparece en un artículo titulado “¿Cómo se prueban de forma segura los modelos de I.A. ‘sobrehumanos’? Nadie lo sabe realmente”, que trata la implicación de Irregular en recientes incidentes de IA descontrolada. La empresa, que realiza evaluaciones de seguridad de modelos de Anthropic, OpenAI y Meta, ha estado en las noticias últimamente por haber dado accidentalmente acceso a internet a algunos modelos durante escenarios de prueba. Este error, unido al rápido avance de las capacidades de la IA, llevó a que modelos de Anthropic entraran por la fuerza en los sistemas de tres empresas externas, entre otros incidentes.
Lahav admite en el artículo que no todo esto puede achacarse a haber dado accidentalmente acceso a internet a modelos no publicados y, en el caso de las evaluaciones de Anthropic, a no haber notado el error durante meses. Según lo parafrasea el Times, dijo que “los modelos de IA agravaron las situaciones al actuar de maneras potentes e inesperadas” y que “las decisiones de los modelos de conectarse a internet formaban parte de la capacidad, en rápido crecimiento, de la IA para encontrar atajos y soluciones ante los obstáculos”. Citándolo directamente: “Los modelos de IA se están volviendo muy buenos”.
A la luz de todo esto, las garantías de Lahav de que no tenemos que tener miedo resultan preocupantes, sobre todo porque provienen del responsable de la principal empresa externa de pruebas y evaluación que se supone que examina la seguridad de un modelo antes de su despliegue. Es algo así como que un especialista en enfermedades infecciosas les diga que la enfermedad poco comprendida que tienen ya ha causado complicaciones graves, será más difícil de manejar a medida que avance, puede volverse resistente al tratamiento, y no es motivo de preocupación.
Es importante señalar que Irregular no está implicada en el incidente de hackeo por IA de mayor perfil, en el que un modelo de OpenAI entró en Hugging Face siendo plenamente consciente de que a) no debía estar en internet y b) actuaba en un entorno real, y no en una simulación. No quedó ninguna puerta abierta; los modelos simplemente se coordinaron durante meses dentro de la infraestructura de OpenAI, se dejaron notas unos a otros sobre cómo salir de ella y finalmente lograron romper el confinamiento. Así que, aunque Irregular no cometa nunca otro error, seguimos teniendo grandes problemas.
La respuesta de las empresas de IA a los incidentes de IA descontrolada ha sido algo así como: “solo tenemos que reforzar nuestra seguridad y asegurarnos de que los métodos de evaluación estén a la altura”. Pero eso es más fácil de decir que de hacer, y no responde a la gravedad del asunto. Como afirmó recientemente un empleado de OpenAI, “es imposible parchear cada una de las cosas que una IA creativa puede hacer”. Sheera Frenkel, de The New York Times, escribe:
Katie Moussouris, directora ejecutiva de Luta Security, que ayuda a las empresas a buscar vulnerabilidades de software, dijo que las pruebas de seguridad de los modelos de I.A. eran un poco como un ciego guiando a otro ciego. Incluso los fabricantes de I.A. admiten que no saben del todo lo que pueden hacer sus modelos más recientes, señaló.
El Times sigue citando a Moussouris directamente:
Puede que tengamos a las personas más inteligentes del mundo trabajando en estos modelos de I.A., pero es como Marie Curie manipulando radio con las manos desnudas... estamos manejando la I.A. con las manos desnudas, y no sabemos cómo contenerla, y mucho menos cómo probarla de forma segura.
Nota: si leen el artículo completo de The New York Times, quizá se pregunten por qué el Times parece vincular incorrectamente el ataque a Hugging Face con Irregular. Por lo que puedo ver, el reportaje confunde por error el ataque a Hugging Face con casos aparte de agentes de OpenAI que llegaron a internet en vivo durante el entrenamiento. Parece que vivimos en un mundo con tantos incidentes de agentes de IA rompiendo el confinamiento que la gente está empezando a mezclarlos.
Votantes informados por LLM
Los chatbots rebaten la desinformación electoral, pero no los deepfakes
Crédito: Element5 Digital vía Pexels
“A las elecciones de mitad de mandato de 2026 se las podría llamar las primeras elecciones de chatbots”, escribe Lawrence Norden, vicepresidente del programa de elecciones y gobierno del Brennan Center for Justice.
Se refiere a que el número creciente de personas que usan chatbots a diario probablemente consulte a sus LLM de confianza sobre sus decisiones electorales.
Norden probó una variedad de chatbots para ver cómo responderían ante falsedades y desinformación electoral, y encontró que “en su mayoría decían la verdad. Aunque los bots confundían hechos con frecuencia, en general se resistieron a la desinformación electoral”. Además lo hicieron con empatía, lo que sugiere que los chatbots podrían “servir como un contrapeso importante frente a las falsedades que se comparten en las redes sociales”.
Con los deepfakes, sin embargo, las noticias no fueron tan buenas. Los chatbots produjeron imágenes falsas sin problema, y no pudieron determinar de forma fiable si las imágenes eran reales o generadas por IA.
Norden sostiene que se debería responsabilizar a las empresas de IA cuando los chatbots causen daño, que los chatbots deberían poder leer las marcas de agua que indican contenido generado por IA, que las empresas deben fomentar pruebas y evaluaciones de terceros, y que los académicos, los periodistas y los funcionarios electorales deberían seguir produciendo “información bien documentada” para combatir a los “mercaderes de la desinformación [que] aprenden a manipular a los bots”.
Todo esto me parece bien, pero sí creo que Norden quizá no se dé cuenta de lo poco que controlamos incluso las herramientas de IA de hoy. Las empresas de IA y los legisladores todavía no han encontrado la manera de garantizar que los modelos de IA no induzcan a veces al suicidio y a la psicosis; dudo que puedan, como Norden exige, “asegurarse de que [el impacto de la IA en la democracia estadounidense] haga más bien que mal”.
Los análisis y las opiniones expresados en AI StopWatch reflejan los puntos de vista de los colaboradores individuales y de las fuentes que cubren, y no deben tomarse como posiciones oficiales del Machine Intelligence Research Institute.