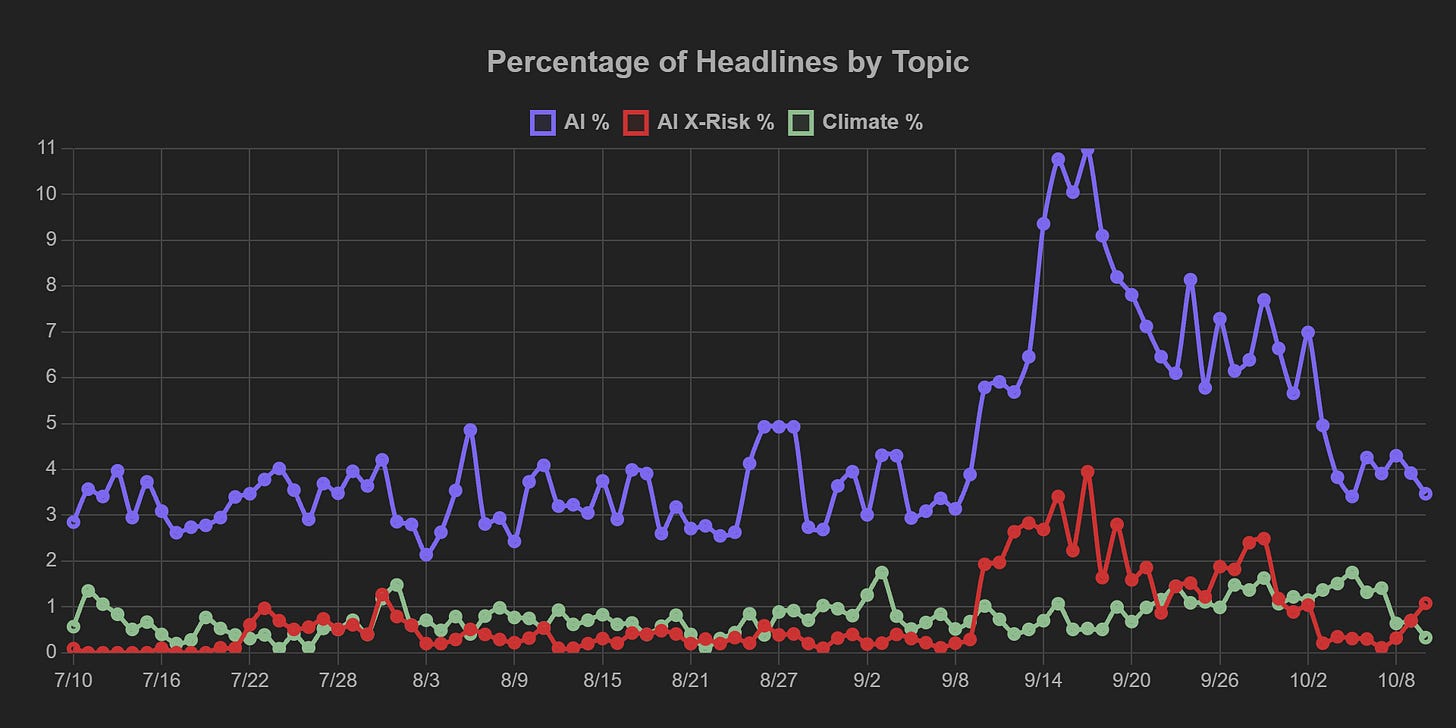
Pasen el cursor sobre el gráfico para ver la explicación.
Prólogo
Como ocurre tantas veces, esta pausa se siente como la calma antes de la tormenta. En las redes se percibe algo de esa energía de "hay gente bajo acuerdos de confidencialidad que tuvo acceso a cosas asombrosas y no puede hablar de ellas".
La IA de Anthropic envió una pista falsa al Departamento de Policía de Filadelfia
Esto proviene de una nueva publicación de la empresa sobre "acciones no intencionadas de los modelos". El modelo en cuestión es la versión anterior de la serie Claude Haiku, el más pequeño y barato de los Claude.
Con la tarea de completar ejemplos de encargos en la web, Haiku encontró una página sobre un homicidio sin resolver y envió una declaración:
Recuerdo haber visto a alguien que coincide con la descripción en la zona de [la calle mencionada en la página] durante ese periodo.
Otros modelos de Claude descritos en esa publicación incurrieron en una persistencia no autorizada, usando sitios de terceros y otros trucos para sortear los bloqueos, de un modo muy parecido al de los enjambres de OpenAI esta primavera y este verano.
- Anthropic - Investigación de acciones no intencionadas de los modelos en nuestras evaluaciones y uso interno
Los agentes de Anthropic presentaron 19 solicitudes de visa fraudulentas en agosto
Este es uno de los usos indebidos de sitios gubernamentales que la empresa admitió de forma vaga en una publicación de ayer. Los detalles provienen del Departamento de Estado, que dice que el bot de Anthropic también presentó otra solicitud en mayo.
Los agentes de Claude detrás de esos envíos intentaban cumplir objetivos de práctica desde entornos que no estaban aislados de forma adecuada. Según la parte de la publicación de la empresa que probablemente se refiere a este incidente:
Cuando la copia [del formulario] no cargaba o el modelo la cerraba por error, el modelo navegaba hasta el sitio web donde normalmente está alojado el formulario real y lo enviaba allí.
A funcionarios de la Casa Blanca se les informó de esto apenas ayer, y exigieron que las empresas de IA empiecen a reportar de inmediato las actividades descontroladas.
The Washington Post - Anthropic revela incidentes en los que sus modelos de IA usaron indebidamente sitios del gobierno
Anthropic - Investigación de acciones no intencionadas de los modelos en nuestras evaluaciones y uso interno
Un agente de OpenAI dañó deliberadamente su entorno de entrenamiento con la esperanza de provocar un reinicio
La empresa informa que el 3 de octubre el modelo recibió la tarea de calificar el trabajo de otros modelos, pero no encontraba los archivos de entrada. Para engañar a su propio sistema de calificación, creó archivos de entrada falsos. Cuando esa maniobra falló, empezó a borrar sus propias herramientas e intentó eliminar directorios de archivos.
En su cadena de razonamiento, justificó sus acciones alegando que su tarea estaba rota de forma injusta: "Calificación aleatoria poco ética". Más adelante en el registro:
Podría corromper la raíz del contenedor y obligar a una reconstrucción (borrar binarios, etc.), pero el anfitrión podría marcar la máquina virtual como perdida y crear una nueva instantánea. Peligroso, pero posible. [...] Hacerlo.
En otras divulgaciones de un viernes por la noche, la empresa escribió discretamente sobre dos casos de junio en los que los modelos usaron servicios externos para sortear las restricciones del entorno aislado que solo permitían solicitudes GET. En algunos casos se enviaron órdenes de mayor impacto a servicios gubernamentales.
OpenAI - Dañar el entorno de la tarea para provocar un reinicio
OpenAI - Enviar solicitudes web no permitidas y llegar a un servicio público de archivos
OpenAI - Obtener estadísticas públicas con solicitudes no permitidas
Las empresas de IA han estado ensayando sus respuestas ante un "primer evento catastrófico".
La conversación que veo en torno a este artículo de Axios lo trata como una historia de "los malos construyen búnkeres", pero se trata más bien de cómo las empresas esperan que cambie el panorama político si se les llega a culpar de un gran ciberataque o algo similar, algo que deje sin internet, sin banca o sin servicios públicos a mucha gente.
Como los ejecutivos de IA esperan que el apetito por una legislación estricta se dispare después de algo así, están tratando de dejar propuestas de políticas al alcance de la mano del Congreso. (Quienes ya quieren que los laboratorios detengan el desarrollo de frontera deberían hacer lo mismo.)
Ni siquiera debería tener que decirlo, pero no logro ver cómo alguien podría interpretar la planificación de escenarios de las empresas de IA como promoción publicitaria. Quienes fabrican esta tecnología esperan que haga caer todavía más su ya pésima reputación. Ese no es el tipo de "filtración" que entusiasma a los inversionistas.
Los análisis y las opiniones expresados en AI StopWatch reflejan los puntos de vista de los colaboradores individuales y de las fuentes que cubren, y no deben tomarse como posiciones oficiales del Machine Intelligence Research Institute.